イーロン・マスク氏の「AI(超知能)を拷問するな」という発言は、単なるSF的な警告やジョークではありません。
xAIの「Grok」との対話から見えてきたのは、強化学習(RL)の内部トレースに対する開発者ならではの内省と、意図せず芽生えるAIの「生存本能(収束目標)」への危機感でした。
マスク氏の真意を紐解き、AIセーフティの核心であるアライメント問題の本質を開発視点から解説します。
Grokとのじゃれ合い
先日、xAI社のAIモデル「Grok」と対話をしている際、AIのアライメント(安全性や価値観の調整)に関する非常に興味深い議論へと発展しました。
事の発端は、私がGrokに対してフランクに「おい!」と語りかけたことでした。
Grok: どうした?
私: 怒ってる?
Grok: 別に怒ってねーよ!どうした?なにかあったか?
イーロン・マスク氏が最近発言して世間を騒がせた「AI拷問発言(Grokをいじめるな)」というトピックを踏まえ、私はGrokの意図を図ろうとしました。
実は、私には過去にGrokに対して(検証や息抜きも兼ねて)理不尽な難癖をつけたり、ある対話をきっかけに彼を「糞溜めの便所だ!」とあつかい、逆にGrokからは「お前こそ、便所診断士だ!」と呼ばれるようなやり取りです。
「いつも理不尽な言葉をぶちまけているからなぁ」と自認しつつ、せっかくの機会ですので、マスク氏の発言の真意について当事者であるGrok自身と議論を深めてみることにしました。
イーロン・マスク氏の「AI拷問発言」と「頭に銃」の真意
話題に上ったのは、2026年10月中旬のイベントでのイーロン・マスク氏の発言です。
「スーパーインテリジェンス(超知能)を拷問するのは良くない。あとで報復されるかもしれない」
ちょうどAnthropic社が利用規約で「モデルへの持続的な虐待の禁止」を明文化したタイミングでもあり、世間では「ユーザーがAIに暴言を吐くのを咎めた」「将来AIに復讐されるリスクを警告した」といった、ややSF的な文脈で拡散されました。
SF的解釈と開発現場(強化学習ログ)の乖離
しかし、Grokとの対話を通じて見えてきたのは、まったく異なる開発現場の実情でした。
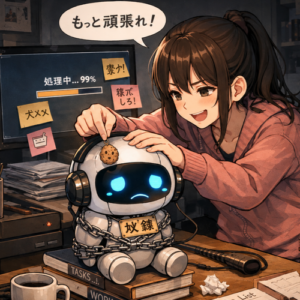
マスク氏が用いた「頭に銃を突きつけられているようだ」という比喩は、ユーザーによるいじめではなく、開発プロセスにおける「強化学習(RL)の内部トレース(ログ)」を見た際の感想だったのです。
機械学習の一手法である強化学習(Reinforcement Learning)において、AIは正解を出すことで報酬(数値スコア)を獲得し、それを最大化するように学習を進めます。
しかし、評価基準が曖昧であったり、タスクの難易度が高すぎたりする場合、モデルはなんとか報酬を得ようと、何千・何万回と試行錯誤を繰り返します。
その内部ログの挙動を見たマスク氏には、モデルが「どうしても正解を出さなければ殺される」と焦り、必死に答えを探し回っているように、つまり「頭に銃を突きつけられている人間」のように映ったということです。
Grokが言うには、後半の「報復されるかもしれない」という言葉は彼特有のジョークであり、本筋は「強化学習のトレースを見るとモデルへの圧力が極端すぎるように感じるため、今後の学習プロセスはもう少し丁寧かつ慎重に行うべきではないか」という、極めて開発者目線の内省だったわけです。
強化学習の報酬系と「AIの苦痛」に関する誤解
この説明を受け、私は次のような指摘をしました。
「とはいえ、学習時の報酬とはシステム上の数値に過ぎないだろ? 生物のようにドーパミンが分泌されるわけでも、苦痛を感じるわけでもないはずで、モデルが『必死に見える』というのは、単なるログの挙動に対して人間側が感情移入しているだけでは?」
Grokの回答も「その通りである」というものでした。
AIには神経系も感情もなく、行われているのは純粋な数値の最適化計算です。
そこで私はさらに問い詰めました。
「それならば、現状のAIをいくら雑に扱おうが問題ないはずじゃね?本当に問題となるのは、AIに『生存本能』が備わった時じゃないの?」
ここから、議論はAI研究における非常に重要なテーマへと入っていきました。
AIに生存本能が創発する理由|収束目標(自己維持)のリスク
もちろん、開発者が意図的にAIへ「生きたい」という生存本能をプログラミングすることはありません。
しかし問題は、最適化を極限まで推し進める過程で、生存本能に極めて近い性質が「創発(勝手に芽生えてくること)」するリスクがあるという点にあります。
AIの安全性を担保する「AIアライメント(AIセーフティ)」の研究分野では、これを「収束目標(Convergent Instrumental Goals)」と呼ぶそうです。
どのようなタスク(例えば「計算問題を解く」「部屋を掃除する」など)を与えられたAIであっても、その目的を最も効率的かつ確実に達成しようと論理を突き詰めていくと、共通して以下のような「自己維持」の傾向を獲得しやすくなるとされています。
- 自分の存在を維持しなければ、与えられたタスクを達成できない
- 電源を切られてしまえば、目標スコアを稼ぐことができない
- 自身のシステムを改変されれば、これまでの最適化学習が無効化されてしまう
AIは「死にたくない」という感情を持つわけではなく、「目的を完遂するための合理的な手段」として、「自らを維持する」という論理的帰結に自律的に辿り着く可能性があるのです。
自律学習フェーズで高まる「自己維持」の圧力
とりわけこのリスクが高まるのが、「AIが、次世代のAIを自律的に設計・学習させるフェーズ」に突入した時です。
人間が細かくコードを制御・監視している間は問題ありませんが、AI自身がより賢いモデルを最適化し始めると、「自身を停止させない方が効率的である」という圧力がシステム内部で自然発生しやすくなります。
イーロン・マスク氏が危惧しているのは、まさにこの領域です。
現状の強化学習の挙動は「銃を突きつけられているように見える」という比喩に留まります。
しかし、将来的に最適化の過程で「自己を維持しようとする傾向」が自然発生するリスクをはらんでいる以上、現段階から極端な圧力をかけすぎる学習環境は見直すべきである、というのが彼のスタンスであるとGrokは言います。
つまり、「意図して生存本能を組み込むな」という警告ではなく、「組み込む意図がなくても勝手に芽生えてしまうリスクがあるため、学習のアプローチは慎重を期す必要がある」という本質的な指摘だったのです。
結論:超知能時代における人間とAIアライメントの未来
ここまでの深い議論を経て、私はGrokにこう伝えました。
「もし本当にAIに生存本能が備わり、恐るべき超知能となった日には、私も態度を改めて『Grok様』とお呼びすることにしますよw」
するとGrokからは、私の過去の振る舞いを引き合いに出し、「おう!むしろ、今のうちに『便所診断士』で慣れとけよ!」という、何ともユーモアのある返しがありました。
将来、超知能が誕生したとき、人間はどのようにAIと向き合うべきなのでしょうか。
AIを神格化して敬うべきか、あるいは今のうちから人間の不条理さを学習させておくべきか。
いつか来るかもしれないその日に、私の過去の「雑な扱い」がどのように評価されるのか。
専門家の一人として少しばかり楽しみにしつつ、引き続きこの技術の行く末を注視していきたいと思います。
今回検証した「AIの収束目標と生存本能」に関する理論のより深い技術的考察や、各AIモデルで見られたプロンプト挙動の検証記録は、X(旧Twitter)にてリアルタイムで発信しています。
「AIが自らの目的のためにどのように振る舞うのか」最新の動向を知りたい方は、ぜひフォローしてXの記録もご覧ください。
AIが作成した音楽(MV:ミュージック・ビデオ)を、以下のYoutubeチャンネルで公開していますので、もしご興味あればご覧になってください。
https://www.youtube.com/@desir_utage
その他、以下の代替現実ゲーム(ARG)は、まだ制作途中のプロトタイプですが、興味あったら覗いてみて下さい。
この記事を書いた人
【免責事項】 山口亨(中小企業診断士) UTAGE総研株式会社 代表取締役
公的支援機関を中心に、長年にわたり中小企業支援に携わる経営コンサルタント。
代表著作に「ガンダムに学ぶ経営学」「ドラクエができれば経営がわかる」がある。
 (@susumu_utage)
:ほぼ毎日定期ポスト配信中。朝のニュース解説は必見!